De meeste onderzoekers gebruiken een groot taalmodel als een soort verbeterde zoekmachine: ze stellen een vraag, krijgen een antwoord dat net aanvaardbaar is, en besteden vervolgens veel tijd aan het bijschaven ervan tot het aan de norm voldoet. De volgende dag doet zich een soortgelijk probleem voor en begint het proces weer helemaal van voren af aan. Wat hier verandering in brengt, is niet een betere prompt, maar het toewijzen van een andere taak aan het model: niet het beantwoorden van vragen over je werk, maar het uitvoeren van een welbepaald deel ervan. Dat gebeurt in je eigen mappen, op je eigen gegevens, binnen regels die je zelf instelt en controles die je zelf kunt verifiëren, en die elke keer worden uitgevoerd. Dat is het verschil tussen een antwoord en een resultaat dat je in je workflow kunt gebruiken.
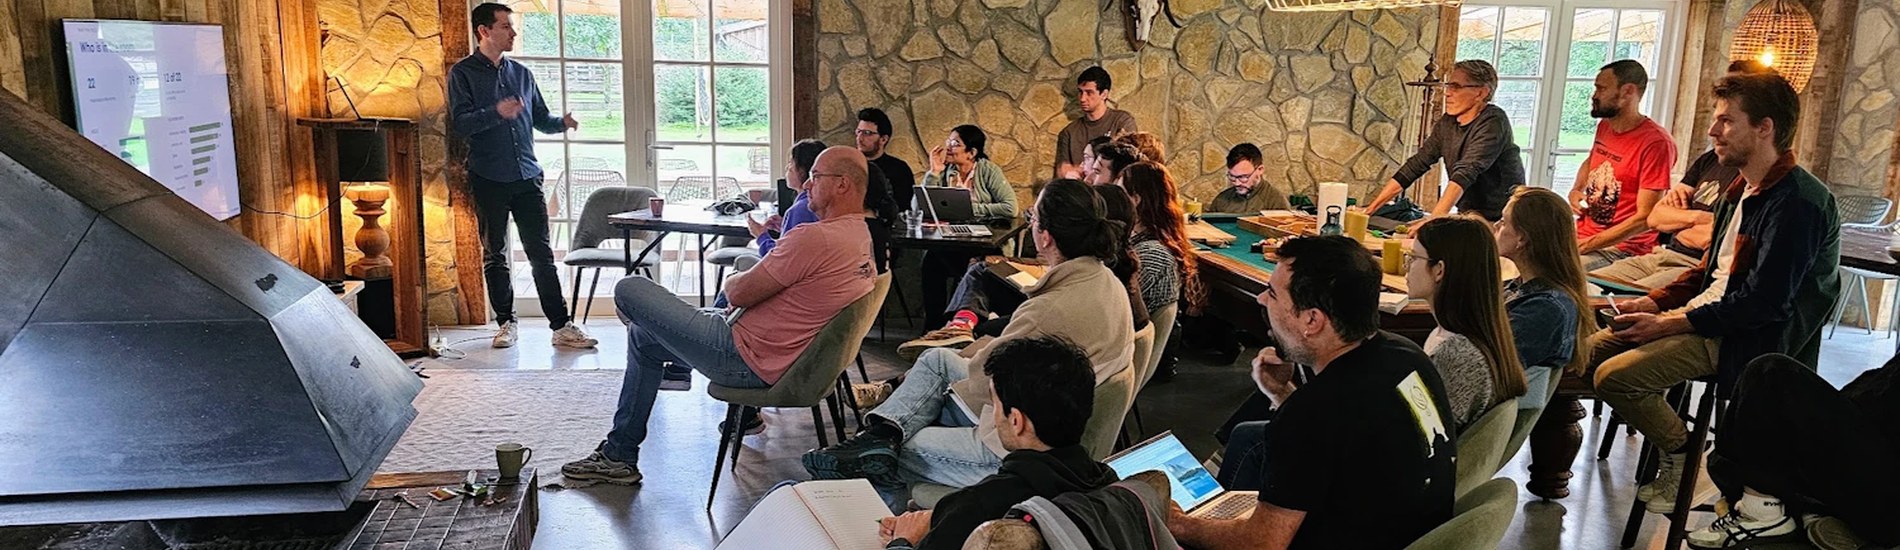
Dit is wat FutureWater op 17 september aan onderzoekers van de Kops-groep bij het Hubrecht Instituut heeft bijgebracht, tijdens een op maat gemaakte workshop van een halve dag tijdens de retraite van de groep. Elke deelnemer werkte aan een taak uit zijn of haar eigen onderzoek. Eén onderzoeker bouwde een beeldverwerkingsplug-in om de beeldanalyse te versnellen. De microscoopcoördinator van de groep stelde een stapsgewijze procedure op voor het afhandelen van microscoopfouten, zodat collega’s veelvoorkomende problemen zelf kunnen oplossen. Anderen werkten aan een literatuuronderzoek dat artikelen screent en elke geciteerde bron controleert, een manuscript dat is geschreven volgens de conventies van hun doeltijdschrift, en een laboratoriumprotocol dat werd omgezet in een projectplan.
Na afloop gaven alle 14 deelnemers die het feedbackformulier hadden ingevuld aan dat ze Claude de komende maand waarschijnlijk in hun eigen werk zullen gebruiken; 12 van hen zelfs zeer waarschijnlijk. Lees meer over de training op onze projectpagina.